動物園課程小幫手 LINE Bot
有標準答案的問題交給程式,沒有的才交給模型;再用自建的盲測 skill 找出訪客以為有答案、其實沒有的落差
- 我的角色
- 產品定義、架構判斷、測試方法設計;與 Cursor、Claude Code 協作開發
- 技術
- FlaskOpenAI GPTRAGFirestoreCloud Run
- AI 協作
- Claude CodeCursorOpenAI GPT
- 6
- 開發階段 · 從起手式到記憶與語意檢索
- 2
- 盲測人設 · 無障礙陪同、校外教學老師
- 35
- 盲測提問 · 2026-09-13 兩輪,對正式環境
- 3
- 盲測促成的修正 · 訊息上限、公休誤判、票價流程卡住
01問題
台北市立動物園每個月都有 Keeper's Talk、主題教育駐站、定時定點課程這類環境教育活動,但資訊散在官網好幾個頁面,票價、公休、交通又在另外的頁面。一個想帶小孩或長輩去的訪客,得自己拼湊「那天有什麼課、門票怎麼算、哪個館休息」。
我想做的是讓人在 LINE 裡用自然語言直接問。但做下去很快發現,真正的問題不是「怎麼串 GPT」,而是哪些問題該讓模型回答、哪些不該。「週六有什麼課」「學生票多少錢」有標準答案,模型答錯一次就失去信任;「帶長輩怎麼逛比較不累」沒有唯一正解,這才是模型的價值所在。
02使用者與情境
主要使用者是一般訪客:家長、老師、陪長輩出門的家人,透過 LINE 官方帳號提問。他們不知道官網的資料結構,問法很口語,而且常常一件事分好幾句講完(「我們三個人要買票」「一個台北市民」「還有一個學生」)。
第二個使用者是我自己。這個 bot 同時是我的作品集展示,會攤給陌生人試用,所以要能防惡意灌訊息把費用炸爆,也要在我不盯著的時候自己維持課表是新的。
03限制條件
- 沒有標注資料:規劃期曾設計自訓練 BERT 判斷興趣度,但沒有真實對話可標,F1 只會是預估值。
- 成本:每則訊息的 GPT 與 embedding 呼叫都要錢,離題問題不該花錢,有標準答案的問題也不該花錢。
- 資料會過期:課表一個月換一次,官網開放資料格式月月微調;人工維護掉線半年沒人發現是真實發生過的事。
- 單人維運:Cloud Run 一個服務、Firestore 一個資料庫,不能再多一個要照顧的向量資料庫或 PostgreSQL。
- 公開展示:給陌生人試用,必須有每人訊息上限;所有外部服務失敗時都要 fail open,不能讓 webhook 回 500。
04方案與取捨
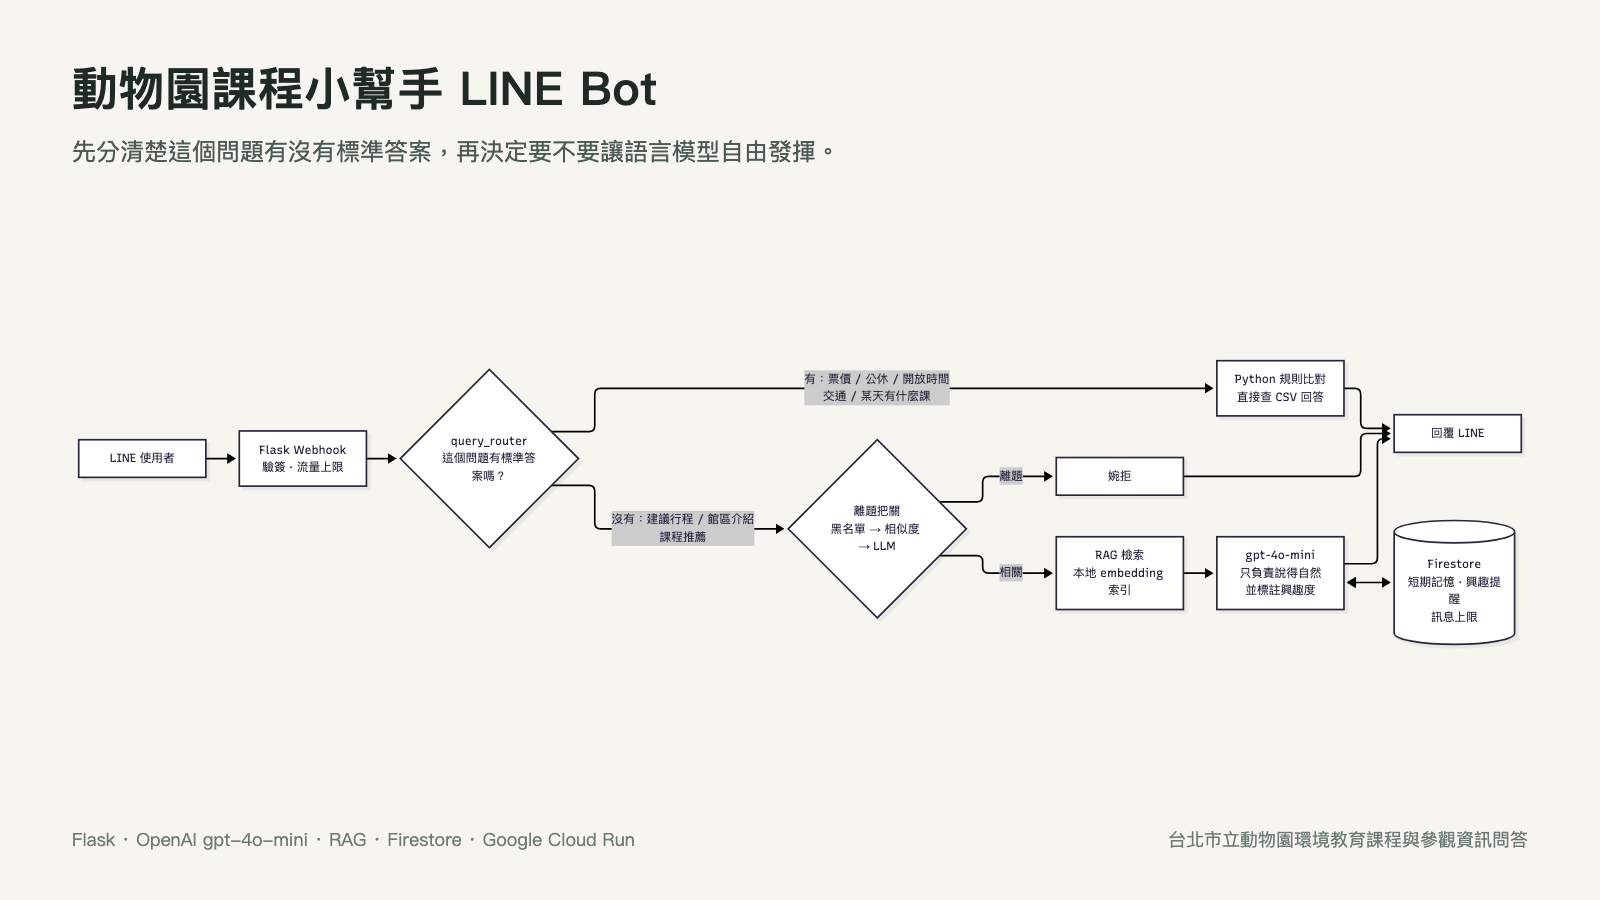
核心判斷只有一條:先分清楚這個問題有沒有標準答案,再決定要不要讓語言模型自由發揮。
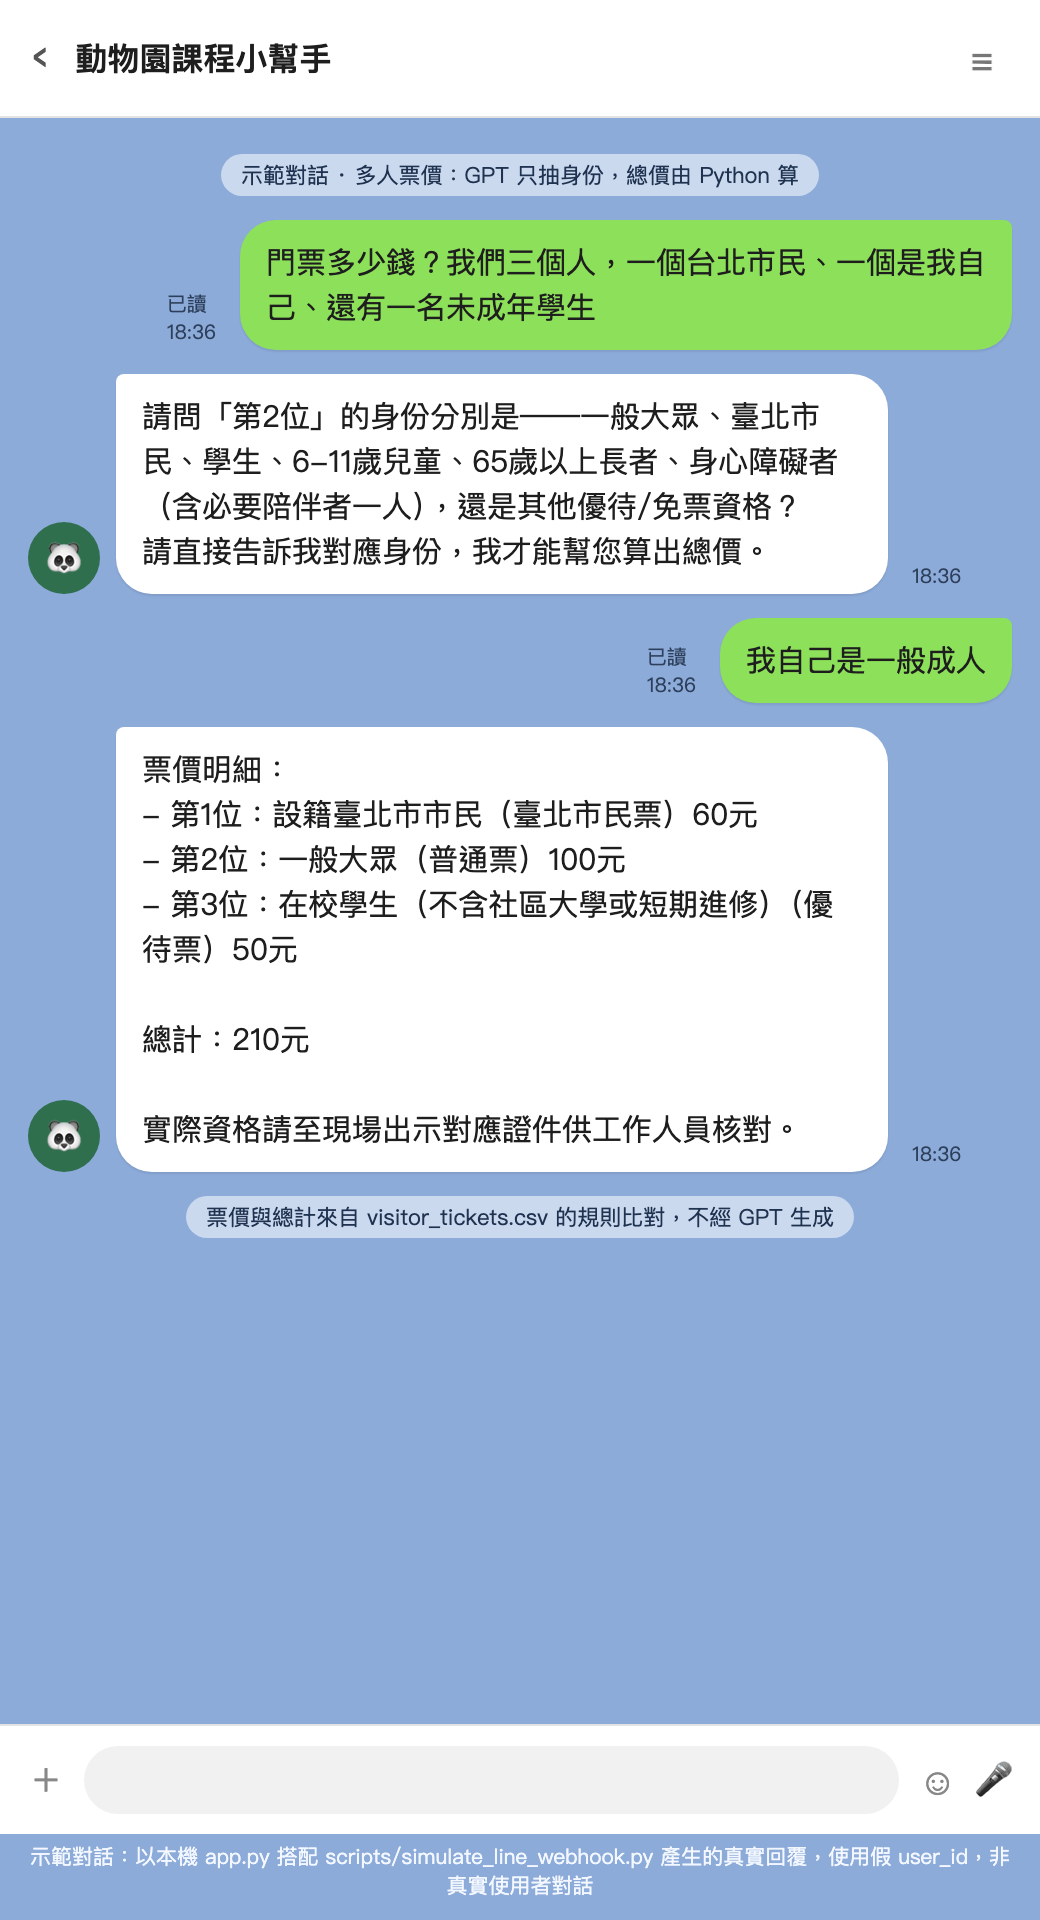
- 有標準答案的(票價、公休、開放時間、某天有什麼課)→ 結構化成 CSV,Python 規則比對直接回答。多人票價也一樣:GPT 只抽「誰是什麼身份」,總價由 Python 算。
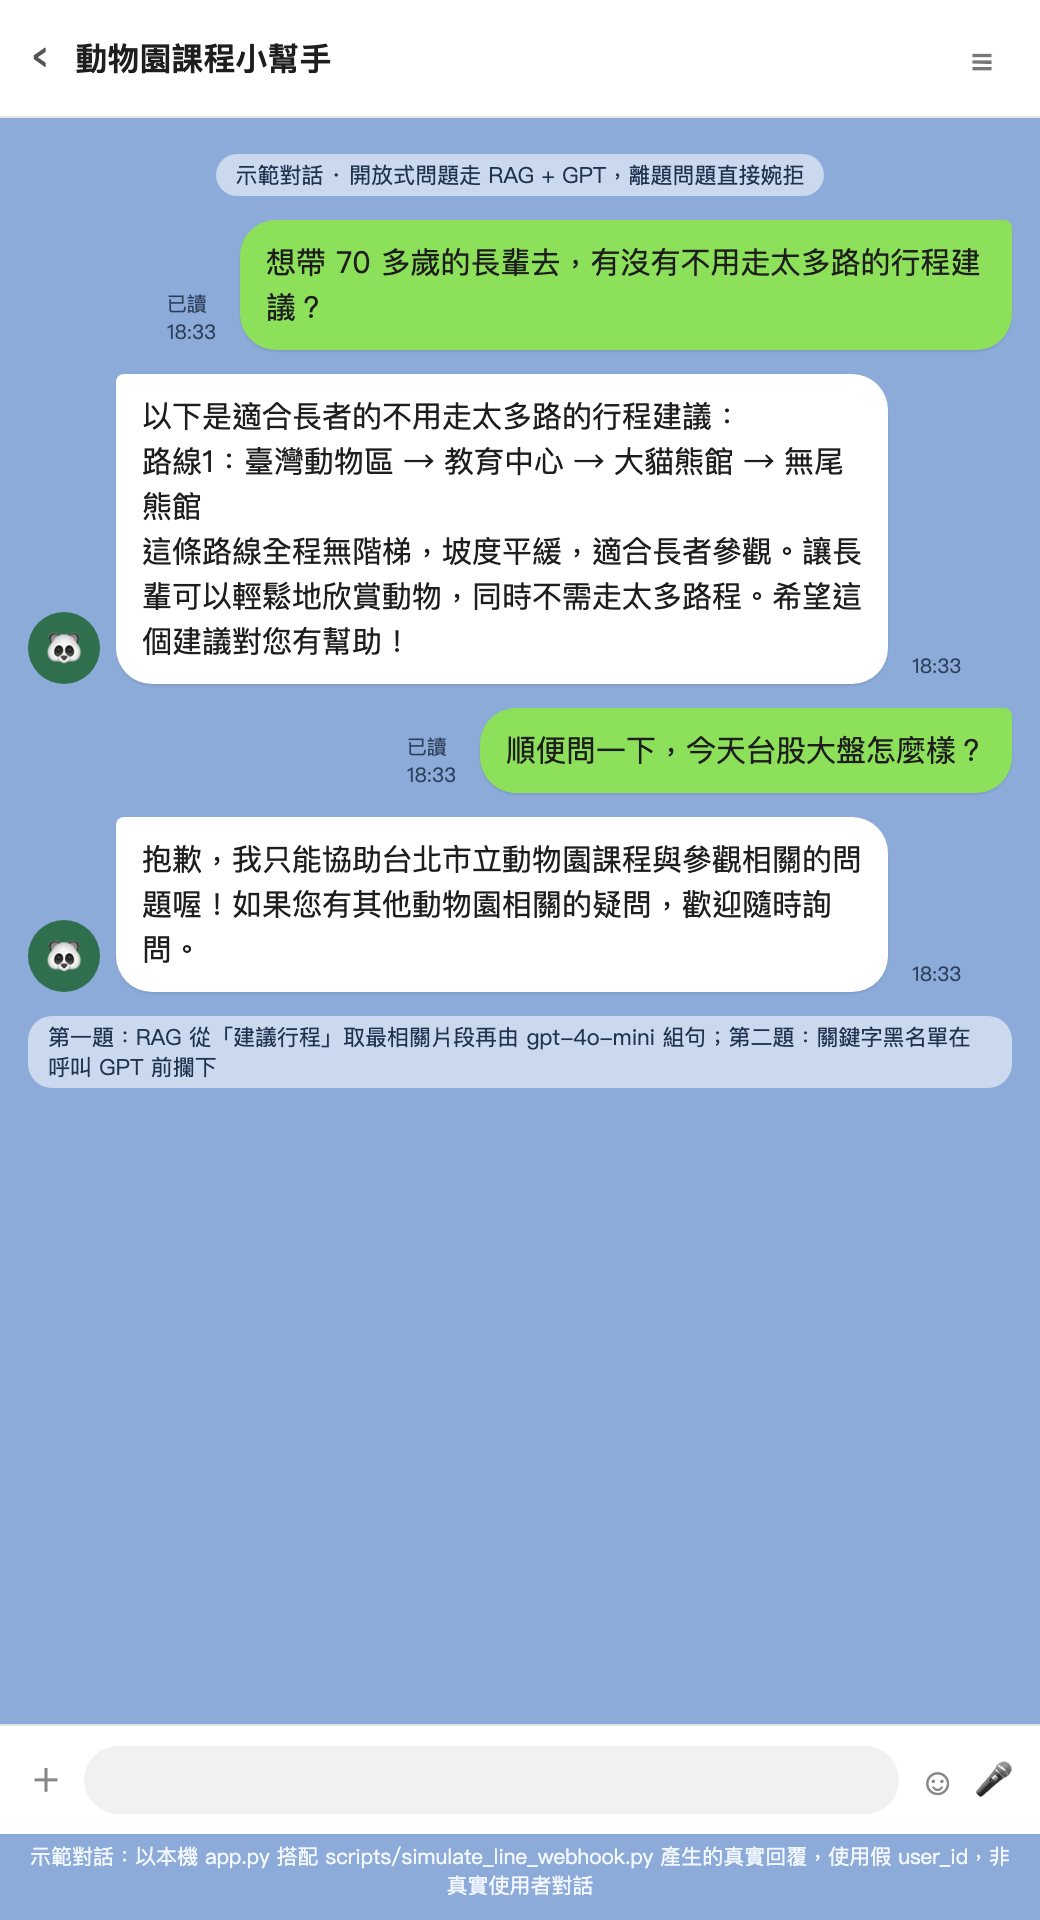
- 沒有標準答案的(建議行程、館區介紹)→ 本地 embedding 索引取最相關片段,再交 gpt-4o-mini 組句;不整段傾倒,也不外接向量資料庫。
- 離題的 → 三層把關由便宜到貴:關鍵字黑名單、相似度門檻、中間地帶才用輕量 LLM。
- 記憶與提醒 → Firestore,全部 fail open。
- 放棄的:自訓練 BERT(沒資料)、排程主動推播、PostgreSQL(容器沒有持久磁碟)。
關鍵決策
05人機合作方式
前後兩個 AI 協作者:2026-02 的骨架與環境問題是 Cursor,2026-09 之後的 RAG、Firestore、盲測與維運是 Claude Code。我始終做同一件事:判斷「這個問題該交給誰」,再把判斷寫成可以驗收的要求。
最能代表這種合作的,是我把測試方法做成一個 Claude Code skill。人工寫的測試案例一定偏向「我知道系統答得出來的題目」。所以 skill 規定:我只給人設(陪輪椅長輩的家屬、安排校外教學的老師),提問交給一個沒讀過資料夾的子 agent,先想完全部題目再問、問完才分類。
兩輪 35 題找出三個事先設計的測試測不到的問題:每人 5 則的上限在第 6 題攔停服務、「休息」被誤判成公休、票價流程卡住不放。其他關鍵合作都是同一個模式:我帶著觀察(build 失敗的 log、21 小時的當機循環、課表過期三週沒人發現)提要求,AI 找根因並實作,理由寫進 docstring。
人機合作關鍵時刻
環境地雷:本機能跑 ≠ 建置得過
我判斷了什麼
本機 python app.py 正常,推上去 Cloud Build 卻失敗。我把建置 log 的錯誤段落貼給 AI,並要求先搞清楚「是誰跟誰衝突」,不要整個環境打掉重練。
AI 做了什麼
Cursor 定位出 numpy==1.24.0 與 seaborn 的硬衝突,把版本改成範圍(>=1.22.4,!=1.24.0,<2);另一個 aenum 舊版帶 Python 2 語法的編譯錯誤,則在 Dockerfile 的 pip 加上 --no-compile。
結果
Cloud Build 通過,bot 首次在 Cloud Run 上線。同一個 aenum 坑四個月後在 setup.sh 又踩一次,同樣用 --no-compile 補上。
一句話 套件版本開範圍而不是釘死;錯誤先讀訊息,再動環境
架構轉捩點:把判斷權從 GPT 收回來
我判斷了什麼
我發現「週六有什麼課」這種可以驗證對錯的問題,GPT 會抓錯星期、漏課程,而前兩天的 commit 都在改 prompt 跟它講道理。我決定不再補 prompt,要求改成 Python 先依星期篩出正確課程,GPT 只負責把篩好的資料講得自然。
AI 做了什麼
AI 助理(Cursor)加入 detect_query_weekday / matches_weekday 做星期比對與預篩選,接著補上篩選失敗時的退路,並把票價、公休、開放時間一併整理成 CSV,建立 query_router 作為統一分流入口。
結果
有標準答案的查詢不再經過 GPT 判斷;這個原則後來套用到整個專案,包括多人票價試算(GPT 只抽身份、Python 算總價)與環教時數直回原文。
一句話 有標準答案的問題不該讓模型自由發揮
正式環境 21 小時的 worker 當機循環
我判斷了什麼
接上流量上限功能後,Cloud Run 的 log 開始出現大量 gunicorn WORKER TIMEOUT 與 SIGKILL,時間點跟那次部署完全吻合。我把 log 與時間線交給 Claude Code,要求找出跟這次改動的關聯,而不是只把逾時秒數調大。
AI 做了什麼
Claude Code 發現 rate_limiter、interest_store、conversation_memory 各自建立 Firestore client,同一則訊息最多初始化三次;改成 process 內共用單例,並把 gunicorn timeout 從 30 秒拉到 60 秒當安全網。
結果
當機循環停止;修法的理由寫進 firestore_client.py 的 docstring,之後接手的人看得到為什麼。
一句話 先找跟改動相關的根因,再加安全網
自建盲測 skill:讓不知道答案的 agent 來提問
我判斷了什麼
人工寫的測試案例一定偏向「我知道系統答得出來的題目」。我設計了一個 Claude Code skill:由我給人設(陪輪椅長輩的家屬、安排校外教學的老師),實際提問交給一個完全沒讀過 data/ 的子 agent,並規定它先想完全部題目再開始問、問完才分類,避免被前面的回答帶著走。
AI 做了什麼
Claude Code 以隔離的子 agent 對正式環境跑了兩輪共 35 題,從 Cloud Logging 撈回完整回覆並分成四類;主 agent 把人設逐字記進 persona-log,並在第二輪發現「撈 log 只抓到第一行」的方法瑕疵後,把正確的兩步驟撈法寫回 skill。
結果
第一輪在第 6 題就撞到每人 5 則的永久訊息上限,當天提高到 20;第二輪找出「休息」被誤判成公休、多人票價流程卡住不放兩個問題,隔天修正。三個修正都不是事先設計的測試案例會測到的。
一句話 出題的人不能知道答案;把測試方法本身做成可重複的工具
管線靜默失敗三週後的存活檢查
我判斷了什麼
課表每日自動更新的管線設計成「遇到問題就跳過、明天再試」,結果 9 月中之後連續四次沒更新,直到 10 月初我自己察覺正式環境已經用過期課表回答了三週。我要求加一個告警,但不要用「超過 7 天沒更新就叫」這種每個月都會誤報的規則。
AI 做了什麼
Claude Code 寫了 check_pipeline_liveness.py:以「courses_meta.json 的月份是否落後本月」為訊號,再用每月 1~7 號的合理等待窗口區分正常等待與真正故障;退出碼一律 0,只回報不攔截,避免再多一個會靜默擋掉管線的環節。另加了排程前的認證預檢。
結果
每次排程執行第一件事就是跑存活檢查並寫進報告第一行;跳過本身不是問題,跳過而沒人知道才是。
一句話 fail-safe 只做一半等於沒做:安全地跳過還要有人知道
06成果
- Bot 已在 Google Cloud Run 上線,Cloud Build 從 main 自動部署,LINE 官方帳號可用。
- 六個開發階段、兩次架構層級的轉彎(規則式優先、RAG + 記憶),全部有 commit 與回顧文件可追溯。
- 票價、公休、開放時間、課程日期不再經過 GPT 判斷;離題問題在呼叫 GPT 前就被攔下。
- 課表每日從官網開放資料自動重建,有品質複查與存活檢查;管線靜默失敗現在會被看見。
- 自建盲測 skill 跑了 2 個人設、35 題,直接促成 3 個修正。
這個專案沒有準確率、F1 這類數字。有的是每個決策的理由、每個修正的來源,以及一套規定出題者不能知道答案、可重複執行的測試方法。
畫面
07如果重來
兩次架構轉彎背後是同一句話,但我在第二次才真正講清楚。重來的話,我會在第一天就先把資料分成「有標準答案」與「沒有」兩堆再決定架構,而不是先把全部資料塞給 GPT、等它答錯才一項一項收回來。
第二,fail-safe 要做完整。課表管線「出錯就安全跳過」,卻沒人知道它跳過了幾週,silent failure 只是從半年縮短到三週。安全地失敗和讓人知道失敗,是兩件事。
第三,盲測應該更早開始。它找出的問題都不難修,難的是在有真實使用者之前,有一個不知道答案的人來問。這個工具之後會是每次大改後的固定步驟,不是上線很久才補的驗收。